sábado, noviembre 21, 2009

no caere tanto del cielo

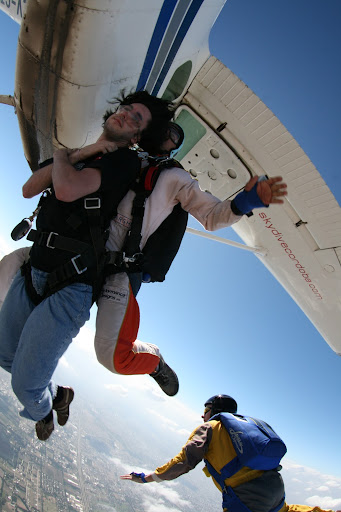
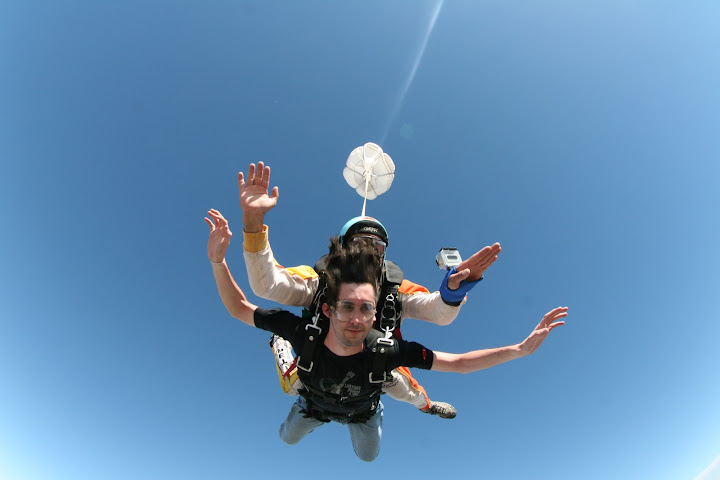
llega un momento en la vida de toda persona en la que se ve saltando de un avion y cayendo al vacio a 200 km/h desde 3000 metros de altura.

ese dia fue para mi hoy :)

algunas fotos y un video

el album completo aca


viernes, noviembre 20, 2009

webless prototipo final

si viste el post anterior encontraste un poco de codigo de mas, para que lo querria uno?

bue, la idea era hacer algo asi:

uno entra a una pagina, pone una url, escribe un poco de javascript/jquery, aprieta probar y nos trae la pagina de resultado renderizandola en el server en webkit y aplicando el codigo que le dimos.

si el snippet que hicimos nos es util lo podemos guardar y nos da una url que podemos usar para obtener el resultado de esa transformacion cada vez que queramos.

no entendes nada? un ejemplo?

* obtener solo los links de los resultados de la primera pagina de google al buscar X
* sacar la cotizacion del dolar de la pagina de algun diario

es interesante tenerlo limpito y nos puede interesar consumirlo periodicamente o usarlo como entrada a otro programa, incluso podemos combinar varias entradas y armar un mashup en una pagina usando los resultados de varios scripts.

todavia no se entiende? ok, vamos con un par de screenshots...

lo que hacemos es poner esta url: www.google.com/search?q=sublime
y este script:


var page = $("html");
page.html($(".l"));
$('.l').wrap('<li></li>');
page.wrapInner('<ul></ul>');
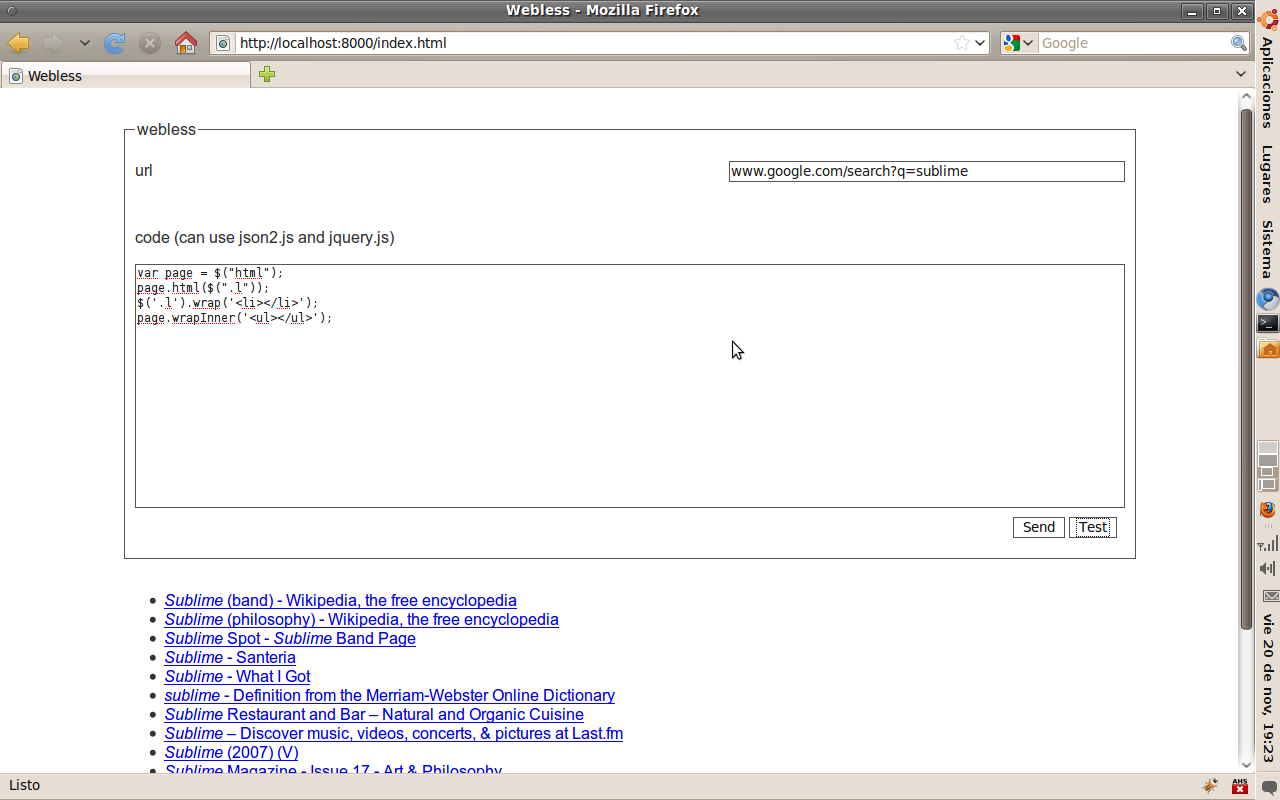

y darle test, el resultado es:


luego elegimos send y lo guarda y nos da una url permanente para accederlo, al hacerlo vemos lo siguiente:


si alguien tiene ganas de seguir jugando con esto o lo hostea en algún lado publico el código por ahí :D

inject fun

el post anterior lo escribi como calentamiento para este que es la realizacion de una idea que tuve hoy (y que se va a completar en el post siguiente).

ya hicimos un browser, ahora estaria bueno manosear el contenido de las paginas no?

la mejor forma que conozco en cualquier lenguaje de manipular html es jquery, asi que estaria bueno poder jugar con el en todas las paginas no? lastima que no todas lo incluyen...

pero si lo inyectamos si lo van a tener :)

entonces tenemos una pagina, un campo para poner codigo js y ejecutarlo y podemos modificar el contenido de la pagina, algo asi:


por si no se ve corri el siguiente script: $('a').html('lol');

ahora vamos a ver un uso mas interesante:


casi me olvido el codigo :)

import os
import sys
import gtk
# https://bugs.launchpad.net/bugs/480398
gtk.gdk.threads_init()
import webkit

class Webless(object):
def __init__(self, url=''):
self.view = webkit.WebView()
self.open(url)

def inject_file(self, path):
'''run a script in a file'''
if os.path.isfile(path) and os.access(path, os.R_OK):
self.inject_script(file(path).read())
return True

return False

def inject_script(self, script):
'''run a script'''
self.view.execute_script(script)

def get_code(self):
'''return the text of the widget'''
self.view.execute_script('oldtitle=document.title;document.title=document.documentElement.innerHTML;')
html = self.view.get_main_frame().get_title()
self.view.execute_script('document.title=oldtitle;')
return html

def open(self, url):
if not url.startswith('http://') and not url.startswith('https://'):
self.url = 'http://' + url
else:
self.url = url

self.view.open(self.url)

class Browserless(gtk.Window, Webless):
def __init__(self, url=''):
gtk.Window.__init__(self)
Webless.__init__(self, url)
self.add(self.view)

class Browser(gtk.Window, Webless):
def __init__(self, url=''):
gtk.Window.__init__(self)
Webless.__init__(self, url)
self.set_title('Browser')
self.set_default_size(640, 480)

scroll = gtk.ScrolledWindow()
scroll.set_policy(gtk.POLICY_AUTOMATIC, gtk.POLICY_AUTOMATIC)
scroll.set_shadow_type(gtk.SHADOW_IN)

scroll.add(self.view)

vbox = gtk.VBox()
hbox = gtk.HBox()

entry = gtk.Entry()
entry.connect('activate', self._on_url_changed)

if self.url:
entry.set_text(self.url)

code = gtk.Entry()
code.connect('activate', self._on_run_code)

getcode = gtk.Button("html to clipboard")
getcode.connect('clicked', self._on_get_code)

hbox.pack_start(code, True, True)
hbox.pack_start(getcode, False)

vbox.pack_start(entry, False)
vbox.pack_start(scroll, True, True)
vbox.pack_start(hbox, False)
vbox.show_all()

self.add(vbox)

self.connect('delete-event', lambda *args: sys.exit(0))

def _on_get_code(self, button):
'''copy the content of the html window to the clipboard'''
code = self.get_code()
gtk.clipboard_get().set_text(code)

def _on_url_changed(self, entry):
'''called when the url changes'''
url = entry.get_text()
self.open(url)

def _on_run_code(self, entry):
'''called when the url changes'''
code = entry.get_text()
self.inject_script(code)

def process_events():
while gtk.events_pending():
gtk.main_iteration(True)

if __name__ == '__main__':
browser = Browser('www.google.com/search?q=emesene')

def inject_fun(view, frame):
browser.inject_file('js/jquery.js')
browser.inject_file('js/json2.js')

browser.view.connect('load-finished', inject_fun)

browser.show()

gtk.main()

Browser en pygtk con webkit en unas cuantas lineas de codigo


import sys
import gtk
# https://bugs.launchpad.net/bugs/480398
gtk.gdk.threads_init()
import webkit

class Browser(gtk.Window):
def __init__(self, url=''):
gtk.Window.__init__(self)
self.set_title('Browser')
self.set_default_size(640, 480)

self.url = url

scroll = gtk.ScrolledWindow()
scroll.set_policy(gtk.POLICY_AUTOMATIC, gtk.POLICY_AUTOMATIC)
scroll.set_shadow_type(gtk.SHADOW_IN)

self.view = webkit.WebView()
scroll.add(self.view)

vbox = gtk.VBox()

entry = gtk.Entry()
entry.connect('activate', self._on_url_changed)

if self.url:
entry.set_text(self.url)
entry.activate()

vbox.pack_start(entry, False)
vbox.pack_start(scroll, True, True)
vbox.show_all()

self.add(vbox)

self.connect('delete-event', lambda *args: sys.exit(0))

def _on_url_changed(self, entry):
'''called when the url changes'''
self.url = entry.get_text()

if not self.url.startswith('http://') and not self.url.startswith('https://'):
self.url = 'http://' + self.url

self.view.open(self.url)

if __name__ == '__main__':
browser = Browser('www.google.com')
browser.show()
gtk.main()

domingo, noviembre 15, 2009

/etc/hosts

127.0.2.1 reader.google.com
127.0.2.1 slashdot.org
127.0.2.1 reddit.com
127.0.2.1 clarin.com
127.0.2.1 criticadigital.com
127.0.2.1 lanacion.com.ar
127.0.2.1 lavoz.com.ar
127.0.2.1 ole.com.ar


veamos cuanto duro

viernes, noviembre 13, 2009

travlr.in

Algunos saben, otros no, pero con mi hermano y un amigo estamos trabajando en un proyecto llamado travlr in hace ya casi un año..


Si bien no esta 100% completo, ya se puede usar, asi que pensamos que es hora de empezar a pasar verguenza! :P


El proyecto se llama travlr.in (traveler in - viajero en) y pueden encontrarlo en www.travlr.in


Travlr.in pretende responder a las típicas preguntas: que hacer? donde? cuando? y tambien mostrarte que cosas hay a tu alrededor, que puede ser desde negocios, plazas, bares y hospitales hasta fiestas para el fin de semana y eventos historicos que sucedieron en cualquier parte del mundo.


Si sos de Córdoba vas a ver que el centro de la ciudad esta lleno de informacion, ya que nos tomamos el trabajo de salir y tomar nota de todos los negocios, telefonos publicos, puestos de diarios y revistas, paradas de colectivos y un largo etcetera (faltan un par de cuadras y el centro estaria completo).


El sistema no tiene mucha informacion actualmente, ya que la idea es que cada uno ponga lo que le interese de su alrededor para compartirlo con el resto. Algo así como una wikipedia de lugares y eventos, mantenida por la comunidad..
Si tenes un negocio podes cargarlo en travlr.in, si haces una fiesta tambien! cualquier cosa es posible, no pretendemos imponer ninguna estructura sobre lo que se puede poner en el mapa y lo que no, simplemente queremos que les sea una herramienta util a cada uno de ustedes, sin importar si estan marcando todos los arboles de córdoba o quizas puntos de avistamiento de ovnis, no nos importa! a mas información y mas variada mejor!


Como se usa?

Cualquiera puede buscar contenido en travlr.in sin necesidad de una cuenta, pero si deseas crear contenido, solo tenes que entrar a travlr.in, clickea en “ingresar” y luego en “Registrarse”, create una cuenta y ya podes crear cualquier cosa!


Para buscar, solo tenes que posicionar el mapa en donde sea que te interese buscar algo, escribir en la barra de busqueda y darle click a la lupa.
Para crear, solo tenes que clickear en + y luego hacer click en donde sea que esto se encuentre para localizar lo que sea que estes creando, luego agrega informacion sobre el elemento creado y listo! Ya podes crear eventos sobre ese lugar, agregar fotos, videos, comentarios, etc

Mucha mas informacion y en mas detalle en www.wiki.travlr.in

Se aceptan criticas de cualquier tipo, a no abstenerse que las necesitamos!

martes, noviembre 10, 2009

como subir attachments a couchdb desde un formulario HTTP (plus 300 posts)

algo que costo poner a andar fue subir attachments a un documento desde una pagina web, termine leyendo como lo hace futon (linea 886, el frontend de couchdb) y quedo algo asi:

en el html

   <div id="upload">
<form id="upload-form" method="POST" action="" enctype="multipart/form-data">
<p id="upload-msg"></p>
<label for="_attachments">Archivo</label>
<input type="file" name="_attachments" id="image-file"/>
<div class="buttons">
<input type="hidden" value="" name="_rev"/>
<button onclick="return ui.upload();">Adjuntar</button>
</div>
</form>
</div>
</div>


en el codigo javascript:

// en algun lado del init correr esto
$('#upload-form').ajaxForm();

ui.upload = function () {
var id = $("input[name='_id']").val(), form = $('#upload-form'), field = $('#image-file');

if (field.val().trim() === '') {
ui.error("Archivo no seleccionado");
return false;
}
else {
form.ajaxSubmit({
url: req.base + id,
success: function(resp) {
field.val('');
ui.message('Imagen adjuntada');
}});
}
};

para hacerlo hace falta jquery y el plugin ajaxsubmit

PD: este es el post 300, 300 posts intrascendentes de una persona intrascendente, keep poluting the interwebs

PD1: vino ian curtis con una pepsi de litro y medio para festejar (la de dos litros esta cara)

PD2: no, no voy a poner una imagen de la pelicula 300 :P

como extender couchdb

que sucede si queres hacer un redirect en couchdb?
que sucede si queres hacer un request a otro host desde js y debido al same origin policy no lo podes hacer?
[Insertar otras preguntas cuya respuesta sea lo que voy a explicar aqui]

mi primer opcion fue leventar un servercito de python en otro puerto, pero eso me complicaba porque violaba el same origin policy y tenia que hacer cosas feas con iframes.

entonces me puse a leer el codigo fuente de couchdb (no hay mucha info en otro lado sobre como hacerlo) y vi que la mayoria de los handlers son extensiones en couchdb.

Si se fijan en el archivo de configuracion, van a ver algo como


[httpd_global_handlers]
/ = {couch_httpd_misc_handlers, handle_welcome_req, <<"Welcome">>}
favicon.ico = {couch_httpd_misc_handlers, handle_favicon_req, "/usr/share/couchdb/www"}

_utils = {couch_httpd_misc_handlers, handle_utils_dir_req, "/usr/share/couchdb/www"}

[snip]


lo que hace eso es que mapea urls a handlers escritos en erlang, el primer elemento de la tupla es el modulo, el segundo es la funcion y el resto son parametros a la funcion.

mi primer experimento fue hacer un redirect para que la url de mi couchapp no quede tan fea, agregue estas linea en /etc/couchdb/local.ini (las otras se veran mas adelante):


editor = {fresita, redirect_editor}
_export = {fresita, export_document}
_style = {fresita, export_style}


y escribi un modulo que se ve asi:

-module(fresita).
-export([redirect_editor/1, export_document/1, export_style/1]).

redirect_editor(Req) ->
couch_httpd:send_redirect(Req, "/fresita/_design/fresita/index.html").

export_document(Req) ->
"/" ++ UrlPath = couch_httpd:path(Req),
[_Export, Database, InputId, Output, StyleId, Format, _FileName] = string:tokens(UrlPath, "/"),
Command = "python /var/lib/fop/export.py --type id --input " ++ InputId
++ " --output /tmp/" ++ Output ++ " --style " ++ StyleId ++ " --format "
++ Format ++ " --url http://localhost:5984/" ++ Database ++ "/",
log(UrlPath),
log(Command),
os:cmd(Command),
couch_httpd:serve_file(Req, Output ++ "." ++ Format, "/tmp/").

export_style(Req) ->
"/" ++ UrlPath = couch_httpd:path(Req),
[_Style, Database, StyleId] = string:tokens(UrlPath, "/"),
os:cmd("python /var/lib/fop/export.py --type style --style " ++
StyleId ++ " --url http://localhost:5984/" ++ Database ++ "/>/tmp/" ++
StyleId),
couch_httpd:serve_file(Req, StyleId, "/tmp/").

log(Text) ->
{ok, Device} = file:open("/tmp/fresita.log", [append]),
file:write(Device, Text ++ "\n").


lo que hace redirect es simplemente redirigir la url a otra que es mas compleja, los otros dos corren procesos externos y devuelven el contenido al browser (el primero genera pdf y rtf usando apache fop y el segundo hace un merge de algunas cosas).

con esto quiero documentar algo que seguro me voy a olvidar en el futuro y aportar mi granito de arena a couchdb para hacer cosas que se complican si solo tenes couchdb y el frontend en el browser.

para hacer andar esto compilas el archivo con erlc archivo.erl y lo pones en algun lugar donde erlang busque, yo lo puse donde estan todas las otras extensiones de couchdb (/usr/lib/couchdb/erlang/lib/couch-0.10.0/ebin/)

sábado, noviembre 07, 2009

llega el momento en la vida de toda persona..

... en la que escribe un lenguaje funcional para la maquina virtual de erlang.

les presento en sociedad a un proyecto que empezo hace dos semanas basado en una idea que tuve hace unos meses :)

los invito a pasar por la escueta pagina que le hice.

www.marianoguerra.com.ar/efene

todavia le faltan algunas cosas pero ya es totalmente funcional.

viernes, octubre 30, 2009

deseo

* mira las velas*
* mira hacia arriba *
* desea ver mas preguntas de python en la lista de python *
* sopla *

estas cosas funcionan?

sino me compre una torta y unas velas en vano.

al menos tengo torta... *

* not

sábado, octubre 17, 2009

Mapeo de busquedas de couchdb-lucene en couchapp

hasta ahora las vistas de couchdb-lucene las metía en couchdb a mano usando la interfaz de administración, pero me molestaba tener un txt por ahí con la vista y no tenerlo en el svn (menos me gustaba que couchapp no lo manejara).

después de preguntar en el irc de couchapp me dijeron que couchapp mapea directorios y archivos a estructuras json, así que lo que antes era


{
"_id": "_design/search-docs",
"fulltext": {
"documents": {
"index": "function(doc) { /* algo */ }"
},
"repos": {
"index": "function(doc) { /* algo */ }"
}
"authors": {
"index": "function(doc) { /* algo */ }"
}
}
}


se convierte en una jerarquía de directorios en la raíz de mi couchapp como la siguiente


fulltext/
|-- authors
| `-- index.js
|-- documents
| `-- index.js
`-- repos
`-- index.js


_design/search-docs pasa a ser _design/fresita (porque ese es el nombre de mi aplicación). Podemos encontrar las búsquedas en el path

_fti/$app-name/$search

por ejemplo:

_fti/fresita/authors?q=Mariano

todo mas prolijo y manejable..

martes, octubre 13, 2009

calculadora en erlang parte (multiplicación división y modulo)

como la otra vez voy a marcar las diferencias

calc_lexer.xrl:


Definitions.

D = [0-9]
AOP = (\+|-)
MOP = (\*|/|%)
WS = ([\000-\s]|#.*)

Rules.

{AOP} : {token,{add_operator,TokenLine,list_to_atom(TokenChars)}}.
{MOP} : {token,{mul_operator,TokenLine,list_to_atom(TokenChars)}}.
{D}+ : {token,{integer,TokenLine,list_to_integer(TokenChars)}}.
{D}+\.{D}+ : {token,{float,TokenLine,list_to_float(TokenChars)}}.
{WS}+ : skip_token.

Erlang code.

----------------------------------------

nada del otro mundo, hacemos lo mismo que con los signos de adicion pero cambiando la expresion regular y el identificador.

ahora el parser:

calc_parser.yrl

Nonterminals
predicate.

Terminals
add_operator mul_operator integer float.

Rootsymbol predicate.

Left 300 add_operator.
Left 400 mul_operator.

predicate -> predicate add_operator predicate : {unwrap('$2'), '$1', '$3'}.
predicate -> predicate mul_operator predicate : {unwrap('$2'), '$1', '$3'}.

predicate -> integer : unwrap('$1').
predicate -> float : unwrap('$1').

Erlang code.

unwrap({_,_,V}) -> V.

----------------------------------

de nuevo, agregamos el identificador del nuevo simbolo no terminal, especificamos la asociatividad de la nueva operacion (tiene precedencia sobre la adicion). Y agregamos la regla para que lo transforme en una estructura de datos.

por ultimo la calculadora en si

calc.erl

-module(calc).
-export([solve/1]).

solve(String) ->
{ok, Tokens, _Endline} = calc_lexer:string(String),
{ok, Tree} = calc_parser:parse(Tokens),
matches(Tree).

matches(A) when is_number(A) -> A;
matches({'+', A, B}) -> matches(A) + matches(B);
matches({'-', A, B}) -> matches(A) - matches(B);
matches({'*', A, B}) -> matches(A) * matches(B);
matches({'/', A, B}) -> matches(A) / matches(B);
matches({'%', A, B}) -> matches(A) rem matches(B);
matches(_) -> error.

----------------------------------------------

agregamos el matching de las nuevas operaciones.

para probar un poco el codigo de build_calc:test()


test() ->
0 = calc:solve("1 + 2 - 3"),
6 = calc:solve("1 + 2 + 3"),
-4 = calc:solve("1 - 2 - 3"),
0.0 = calc:solve("1.0 + 2 - 3"),
6.0 = calc:solve("1 + 2.0 + 3"),
-4.0 = calc:solve("1 - 2.0 - 3"),
3.1 = calc:solve("1.0 + 2.1"),
7 = calc:solve("1 + 2 * 3"),
10 = calc:solve("2 * 3 + 4"),
7.1 = calc:solve("1.1 + 2 * 3"),
10.2 = calc:solve("2 * 3.1 + 4"),
1 = calc:solve("11 % 2"),
2 = calc:solve("1 + 11 % 2"),
11 = calc:solve("11 % 2 + 10"),
ok.


y por ultimo lo probamos


$ erl
Erlang (BEAM) emulator version 5.6.5 [source] [async-threads:0] [kernel-poll:false]

Eshell V5.6.5 (abort with ^G)
1> c(build_calc).
{ok,build_calc}
2> build_calc:build().
Old inliner: threshold=0 functions=[{yeccpars2_7_,1},
{yeccpars2_6_,1},
{yeccpars2_3_,1},
{yeccpars2_2_,1},
{yeccpars2_7_,1},
{yeccpars2_6_,1},
{yeccpars2_3_,1},
{yeccpars2_2_,1}]
ok
3> rl(calc).
ok
4> rl(calc_parser).
ok
5> rl(calc_lexer).
ok
6> build_calc:test().
ok


en la proxima agregamos expresiones anidadas (parentesis)

haciendo andar couchdb-lucene 0.4 en couchdb 0.10.0

como la mayoría de los posts son recordatorios para cuando lo tenga que hacer de nuevo y me haya olvidado y por si a alguien le sirve :D

principalmente seguí estas dos guías

http://github.com/rnewson/couchdb-lucene
http://wiki.fluidproject.org/pages/viewpage.action?pageId=6823331

pero siempre la generalidad termina dejando algunas cosas flotando que hacen que uno pelee (hasta que mira "watch tail /usr/local/var/log/couchdb/couch.log")

supongo que tienen instalado y andando couchdb 0.10.0 (va a ser el caso si usan ubuntu karmic :)

lo primero que hacemos es bajar la versión estable de couchdb-lucene (actualmente la 0.4)


wget http://cloud.github.com/downloads/rnewson/couchdb-lucene/couchdb-lucene-0.4-jar-with-dependencies.jar.gz


luego (como dice el README que uno no lee) desempacamos el jar.gz con unpack200, si lo desempacamos con file-roller java se queja de que es un jar corrupto.


unpack200 couchdb-lucene-0.4-jar-with-dependencies.jar.gz couchdb-lucene-0.4-jar-with-dependencies.jar


creamos un directorio donde lucene pueda trabajar tranquilo


sudo mkdir /usr/local/var/lib/lucene


copiamos el jar


sudo cp couchdb-lucene-0.4-jar-with-dependencies.jar /usr/local/var/lib/lucene


cambiamos el dueño y los permisos al directorio


chown -R couchdb:couchdb /usr/local/var/lib/lucene
chmod -R 0770 /usr/local/var/lib/lucene


configuramos couchdb para que use lucene como indexador de full text search


sudo vim /usr/local/etc/couchdb/local.ini


(mi archivo local.ini tiene lo siguiente)


; CouchDB Configuration Settings

; Custom settings should be made in this file. They will override settings
; in default.ini, but unlike changes made to default.ini, this file won't be
; overwritten on server upgrade.

[couchdb]
;max_document_size = 4294967296 ; bytes

[httpd]
;port = 5984
;bind_address = 127.0.0.1

[log]
;level = debug

[couch_httpd_auth]
;secret = replace this with a real secret

[external]
fti=/usr/bin/java -Dcouchdb.lucene.dir=/usr/local/var/lib/lucene -jar /usr/local/var/lib/lucene/couchdb-lucene-0.4-jar-with-dependencies.jar -search

[update_notification]
indexer=/usr/bin/java -Dcouchdb.lucene.dir=/usr/local/var/lib/lucene -jar /usr/local/var/lib/lucene/couchdb-lucene-0.4-jar-with-dependencies.jar -index

[couchdb]
os_process_timeout=60000 ; increase the timeout to 60 seconds.

[httpd_db_handlers]
_fti = {couch_httpd_external, handle_external_req, <<"fti">>}

; To create an admin account uncomment the '[admins]' section below and add a
; line in the format 'username = password'. When you next start CouchDB, it
; will change the password to a hash (so that your passwords don't linger
; around in plain-text files). You can add more admin accounts with more
; 'username = password' lines. Don't forget to restart CouchDB after
; changing this.
[admins]
marianoguerra = mysecretpassword
;admin = mysecretpassword


(no, ese no es mi password :)

reiniciamos couchdb (lo matamos y lo levantamos de nuevo, esto depende de como lo levantaste, si no sabes, hace "ps aux | grep couchdb" y mata todo lo que parezca sospechoso :D)

lo levantamos de nuevo (yo lo levanto así)


sudo -i -u couchdb couchdb -b


vamos a la interfaz de administracion:


firefox http://localhost:5984/_utils/


elegimos nuestra base de datos, elegimos crear nuevo documento, clickeamos la pestaña source arriba a la derecha y pegamos algo parecido a lo siguiente:


{
"_id": "_design/search-docs",
"fulltext": {
"by_title": {
"index": "function(doc) { var ret=new Document(); ret.add(doc.title); return ret }"
},
"by_content": {
"index": "function(doc) { var ret=new Document(); ret.add(doc.body); return ret }"
}
}
}


el _id cambia por el nombre que mas te guste, las vistas que están adentro de fulltext también cambian según por que quieras indexar, yo estoy indexando por titulo y contenido de unos documentos.

ahora agregamos algunos documentos que puedan ser indexados, para sacarnos la duda de que lucene esta andando mirar la salida de /usr/local/var/log/couchdb/couch.log no debería haber mensajes de error y "ls /usr/local/var/lib/lucene" nos tendia que mostrar varios archivos de nombres extravagantes.

para probar nuestra búsqueda luego de agregar algunos documentos hacemos una query (yo agregue un documento que decía ficticio por todos lados :D)


curl http://localhost:5984/fresita/_fti/search-docs/by_title?q=ficticio


lo cual me devolvió


{"q":"default:ficticio","etag":"1244bf34b28","view_sig":"7368cf7d6f68ec4c60f40c52303de534","skip":0,"limit":25,"total_rows":1,"search_duration":14,"fetch_duration":0,"rows":[{"id":"9ed8514725e1dca56c57471286f5f389","score":2.556901454925537}]}

sábado, octubre 10, 2009

calculadora en erlang parte 2 (agregando floats)

este cambio es muy simple asi que va a ser un post muy corto, voy a resaltar los cambios

en calc_lexer.xrl

Definitions.

D = [0-9]
AOP = (\+|-)
WS = ([\000-\s]|#.*)

Rules.

{AOP} : {token,{add_operator,TokenLine,list_to_atom(TokenChars)}}.
{D}+ : {token,{integer,TokenLine,list_to_integer(TokenChars)}}.
{D}+\.{D}+ : {token,{float,TokenLine,list_to_float(TokenChars)}}.
{WS}+ : skip_token.

Erlang code.

en calc_parser.yrl

Nonterminals
predicate.

Terminals
add_operator integer float.

Rootsymbol predicate.

Left 300 add_operator.

predicate -> predicate add_operator predicate : {unwrap('$2'), '$1', '$3'}.

predicate -> integer : unwrap('$1').
predicate -> float : unwrap('$1').

Erlang code.

unwrap({_,_,V}) -> V.

en calc.erl

-module(calc).
-export([solve/1]).

solve(String) ->
{ok, Tokens, _Endline} = calc_lexer:string(String),
{ok, Tree} = calc_parser:parse(Tokens),
matches(Tree).

matches(A) when is_number(A) -> A;
matches({'+', A, B}) -> matches(A) + matches(B);
matches({'-', A, B}) -> matches(A) - matches(B);
matches(_) -> error.

para facilitar la construccion, les dejo el codigo que tengo en build_calc.erl


-module(build_calc).
-export([build/0, test/0]).

build() ->
leex:file(calc_lexer),
yecc:file(calc_parser),
compile:file(calc_lexer),
compile:file(calc_parser),
compile:file(calc),
ok.

viernes, octubre 09, 2009

escribiendo una calculadora en erlang parte uno

buscando una excusa para seguir aprendiendo erlang encontré una interesante, escribir algo así como un lenguaje de juguete paso a paso y ver para donde dispara (o donde lo abandono)

en una serie de posts (espero seguir escribiéndolos) voy a ir desde cero hasta un interprete interactivo que permita hacer cosas como estas (y mas)

< a = 10 + (2 * 3) # calculo totalmente innecesario
> 16
< b = a * 2
> 32
< a
> 16
< b
> 32
< a == b or b > a
> true


este post es la patada de inicio asi que vamos a ver la herramientas.

Como lenguaje de programación obviamente vamos a usar erlang (que es lo que quiero aprender :D).

para el análisis léxico vamos a usar leex y para el análisis sintáctico y generación del árbol vamos a usar yecc.

para tener erlang hagan algo similar a:

sudo aptitude install erlang

(adaptenlo a su distro)

yecc viene incluido en erlang así que andamos con suerte, a donde no andamos con suerte es con leex, que lo tendremos que bajar de aquí:

http://forum.trapexit.org/download.php?id=184&sid=9eba63c4011e517629e8d5a73e4e2ff5

pueden buscar si hay una versión mas nueva acá:

http://forum.trapexit.org/viewtopic.php?p=43924#43924

lo bajan, descomprimen y ejecutan make en el directorio, luego para poder usarlo en erlang lo que hice (quizás no muy bueno pero anda :P) es crear un directorio llamado /usr/lib/erlang/lib/leex-0.3 y poner adentro leex.beam y el directorio include.

ahora con todo instalado vamos a largarnos con nuestro primer intento (remito a la documentación de cada uno para darse una mejor idea de que hacen y como se usan).

vamos a definir un lenguaje que nos permita sumar y restar números enteros

creemos un directorio llamado match-1-add-sub-ints

y adentro creamos un archivo llamado calc_lexer.xrl con el siguiente contenido


Definitions.

D = [0-9]
AOP = (\+|-)
WS = ([\000-\s]|#.*)

Rules.

{AOP} : {token,{add_operator,TokenLine,list_to_atom(TokenChars)}}.
{D}+ : {token,{integer,TokenLine,list_to_integer(TokenChars)}}.
{WS}+ : skip_token.

Erlang code.


este archivo lo que hace es separar un string en partes (o tokens) que identifican distintos componentes de nuestro lenguaje. En el caso de un lenguaje para sumar números enteros lo que queremos dividir son los números, los signos + y - y descartar los espacios (y también todo lo que venga después de # ya que son comentarios)

en la sección de definiciones definimos las distintas expresiones regulares.

definimos una expresión regular para números enteros

D = [0-9]

una para los signos + y -

AOP = (\+|-)

y una para los blancos y los comentarios

WS = ([\000-\s]|#.*)

luego en la sección Rules. definimos que debe generar (la parte de la derecha) cuando se encuentre con las expresiones de la izquierda.

si se encuentra con un signo + o - que genere una tupla que dice que es un operador de suma, que ponga la posición en donde encontró el token y que convierta lo que matchea la expresión a un atomo.

{AOP} : {token,{add_operator,TokenLine,list_to_atom(TokenChars)}}.

si se encuentra con uno o mas dígitos que genere una tupla que dice que es un entero, la posición del token y el numero entero que encontró.

{D}+ : {token,{integer,TokenLine,list_to_integer(TokenChars)}}.

si encuentra blancos que los salte.

{WS}+ : skip_token.

ahora ya podemos dividir el texto de entrada en pedazos mas manejables gracias a leex, ahora vamos a ver como salio esto. Iniciamos un interprete de erlang y le decimos a leex que genere un modulo de erlang para manejar los tokens que definimos, luego compilamos el modulo generado y lo probamos con un string valido


$ erl
Erlang (BEAM) emulator version 5.6.5 [source] [async-threads:0] [kernel-poll:false]

Eshell V5.6.5 (abort with ^G)
1> leex:file(calc_lexer).
{ok,"calc_lexer.erl"}
2> c(calc_lexer).
{ok,calc_lexer}
3> {ok, Tokens, _Endline} = calc_lexer:string("1 + 2 - 3 # esto es un comentario").
{ok,[{integer,1,1},
{add_operator,1,'+'},
{integer,1,2},
{add_operator,1,'-'},
{integer,1,3}],
1}


como vemos nos devolvió una estructura de datos con las partes que definimos.

ahora vamos a definir un modulo para poder hacer algo con ese árbol que definimos.

creamos un archivo que se llame calc_parser.yrl con el siguiente contenido:


Nonterminals
predicate.

Terminals
add_operator integer.

Rootsymbol predicate.

Left 300 add_operator.

predicate -> predicate add_operator predicate : {unwrap('$2'), '$1', '$3'}.

predicate -> integer : unwrap('$1').

Erlang code.

unwrap({_,_,V}) -> V.


este documento define los nodos no terminales, los nodos terminales el símbolo raíz, la asociatividad de los operandos y luego define la sintaxis (para mas datos sobre las primeras secciones leer la documentación en linea de yecc o algun libro sobre lenguajes, otra opción es ponerse a romper esto y aprender :D).

la parte mas interesante es la que define que un predicado puede estar compuesto por la suma de dos predicados:

predicate -> predicate add_operator predicate : {unwrap('$2'), '$1', '$3'}.

o puede ser solo un entero

predicate -> integer : unwrap('$1').

lo que esta después de los dos puntos es el código erlang ejecutado cuando esa expresión es encontrada. Lo que hacemos es generar otra estructura de datos que vamos a manipular en erlang.

luego tenemos una función de utilidad en erlang para sacar un valor de interés de una tupla.

ahora generamos el modulo erlang que va a parsear la salida de leex y convertirla en otra estructura:


$ erl
Erlang (BEAM) emulator version 5.6.5 [source] [async-threads:0] [kernel-poll:false]

Eshell V5.6.5 (abort with ^G)
1> yecc:file(calc_parser).
{ok,"calc_parser.erl"}
2> c(calc_parser).
{ok,calc_parser}
3> {ok, Tokens, _Endline} = calc_lexer:string("1 + 2 - 3").
{ok,[{integer,1,1},
{add_operator,1,'+'},
{integer,1,2},
{add_operator,1,'-'},
{integer,1,3}],
1}
4> {ok, Tree} = calc_parser:parse(Tokens)
4> .
{ok,{'-',{'+',1,2},3}}


para los curiosos, si se fijan el resultado que nos dio es muy parecido a una expresión de lisp :)

{'-',{'+',1,2},3}


[1]> (- (+ 1 2) 3)
0


bueno, ahora tenemos algo que se parece mucho a lisp, podríamos escribir lisp! pero no :D vamos a interpretarlo con un programa de erlang.

creen un archivo calc.erl que contenga lo siguiente:


-module(calc).
-export([solve/1]).

solve(String) ->
{ok, Tokens, _Endline} = calc_lexer:string(String),
{ok, Tree} = calc_parser:parse(Tokens),
matches(Tree).

matches(A) when is_integer(A) -> A;
matches({'+', A, B}) -> matches(A) + matches(B);
matches({'-', A, B}) -> matches(A) - matches(B);
matches(_) -> error.


lo que hace este modulo es definir una función que recibe un string por parámetro con el calculo que queremos realizar, lo pasar por el analizador lexicografico, le da la salida de este como entrada al parser y con el árbol sintáctico resultante llama a la función matches que gracias al pattern matching se encarga de ejecutar recursivamente la instrucción correcta y devolver el resultado final (o un error en caso de que algo no matchee).

ahora vamos a compilar esto y probarlo un poco:


$ erl
Erlang (BEAM) emulator version 5.6.5 [source] [async-threads:0] [kernel-poll:false]

Eshell V5.6.5 (abort with ^G)
1> c(calc).
{ok,calc}
2> calc:solve("1 + 2 - 3 # deberia dar 0").
0
3> calc:solve("1 + 2 - 3 - 4").
-4


bueno, ya tenemos la primera versión de nuestra calculadora, en la próxima vamos a agregar soporte para números de punto flotante con algunos leves cambios.

para los fiacosos como yo, el codigo de este ejemplo (y de los subsiguientes) esta en github aca:

http://github.com/marianoguerra/match

sábado, septiembre 26, 2009

mi nuevo proyecto

...porque llega el momento en la vida de toda persona en la que programa su propio "framework" web en python...

el proyecto se llama tubes y esta hosteado (usando tubes :P) acá:

http://a-series-of-tubes.appspot.com/


los invito a probarlo, divertirse un rato, hacer preguntas del tipo "porque otro framework web en python???" etc etc.

viernes, septiembre 11, 2009

Pubsubhubbub developer's guide

naming conventions

create directory to hold all the content of this tutorial

$ mkdir pshb
$ cd pshb

download Google App Engine SDK

! pshb trunk needs the latest version of GAE (1.2.4 as of today) to work, but ! the download page display an older version

$ wget http://googleappengine.googlecode.com/files/google_appengine_1.2.4.zip
$ unzip google_appengine_1
.2.4.zip

! GAE needs python 2.5 in order to work, if you have an older or newer version of python install python 2.5 (OS and distro dependent, wont be covered here)

download the latest version of pshb

$ svn checkout http://pubsubhubbub.googlecode.com/svn/trunk/ pubsubhubbub

start pshb

$ python2.5 google_appengine/dev_appserver.py pubsubhubbub/hub/

! note the python2.5 command

check that the hub started

type http://localhost:8080 on your browser, you should see something like:

Welcome to the demo PubSubHubbub reference Hub server!


download the example

# we will need to fetch the tubes library and the example that we will be using.
$ git clone git
://github.com/marianoguerra/tubes.git

# now we will start the example

$ cd tubes
/ihasfriendz/
$ python main
.py

we should see something like:

 * Running on http://0.0.0.0:8081/
* Restarting with reloader...

components used by the example

publish the feed to the hub

go to the following URL on your browser: http://localhost:8080/publish

on the Topic field enter: http://localhost:8081/atom/stream/_MYUSER_ and click publish

! if everything goes OK, then you wont notice anything on the page, that's ok, browsers act that way to 204 responses

! MYUSER is a placeholder for the user you will use to post notices on the test app later (for example http://localhost:8081/atom/stream/marianoguerra)


subscribing to the hub

go to the following URL on your browser: http://localhost:8080/subscribe

on the Callback field enter: http://localhost:8081/callback on the Topic field enter: http://localhost:8081/atom/stream/_MYUSER_ on the Verify token field enter something random like: iwantmahcookie

! MYUSER is a placeholder for the user you will use to post notices on the test app later (for example http://localhost:8081/atom/stream/marianoguerra)

click Do it

! if everything goes OK, then you wont notice anything on the page, that's OK, browsers act that way to 204 responses


create some content

go to the following URL on your browser: http://localhost:8081/files/index.html

post some content on the form, use the user you used as MYUSER


you can check that the item was posted going manually to http://localhost:8081/atom/stream/_MYUSER_, you should see an atom feed there

manually processing the tasks

when running the hub on the dev server we have to run the task queues by hand, to do that go to http://localhost:8080/_ah/admin/queues


on the Tasks in Queue column of the feed-pulls you should see a number different than 0 (that is the number of messages you created since the last execution of that task).

click on the feed-pulls link, there click on the run button.

when we run the feed pulls task, we tell pshb to fetch the feeds that have new content (the ones that did a post to the hub to inform that there is new content)

! on production hubs this tasks are done automatically

now we go again to the Task Queues page, there the event-delivery queue should have a number different than 0 (the number of messages that are pending to be sent to the subscribers), we click on the event-delivery and then we click on the run button.

when we run the event delivery task, we tell pshb to do a POST on every callback url registered for the feeds that were fetched on the feed-pulls task.


seeing it work

now that we created a feed, informed the hub that we had new content, the hub fetched the content and sent it to the callback, we want to see this content, for this go with your browser to http://localhost:8081/new-notices/, you will see the notices that pshb posted back to you the last time.


! if you refresh the page you will notice that the messages aren't there anymore, that's because the example stores the new messages in a Queue that is flushed when the request for new notices is made, in this way you can see only the new messages.

! the example stores all the information on global variables on main.py (this is to make the example simpler), so every time you change something on main.py and save the server will reload the changes and all the data will disappear.

for lazy people

#!/usr/bin/env sh

# create the example directory
mkdir pshb
cd pshb

CWD
=$(pwd)
EXAMPLE
=$CWD/tubes/ihasfriendz

wget http
://googleappengine.googlecode.com/files/google_appengine_1.2.4.zip
unzip google_appengine_1
.2.4.zip

svn checkout http
://pubsubhubbub.googlecode.com/svn/trunk/ pubsubhubbub


# we will need to fetch the tubes library and the example that we will be using.
git clone git
://github.com/marianoguerra/tubes.git

# now we will start the example

echo
"run \"cd $EXAMPLE; python main.py\" on a shell to run the example"
echo
"run \"cd $PWD; python2.5 google_appengine/dev_appserver.py pubsubhubbub/hub/\" on a shell to run the hub"

jueves, septiembre 10, 2009

playing with mercurial API

to make this code be useful a script like this should be run to test

[ -d fresita ] && rm -rf fresita
mkdir fresita
cd fresita
echo "test" > README.txt


my first test script:

import os

from mercurial import ui
from mercurial import commands
from mercurial import localrepo

ui_ = ui.ui()
create = 1
path = os.path.abspath('./fresita')

def repo_initialized(path):
'''return True if the repo is already initialized'''
return os.path.isdir(os.path.join(path, '.hg'))

if repo_initialized(path):
create = 0

repo = localrepo.localrepository(ui_, path, create)
repo.add(['README.txt'])
modified, added, removed, deleted, unknown, ignored, clean = repo.status()

print 'modified', modified
print 'added', added
print 'removed', removed
print 'deleted', deleted
print 'unknown', unknown
print 'ignored', ignored
print 'clean', clean

repo.commit(text="my first commit")


pretty easy :)

Seguidores

Archivo del Blog